Një server mund të funksionojë pa probleme për muaj të tërë dhe të bëhet i padisponueshëm brenda pak minutash për shkak të një disku të dëmtuar, një konfigurimi të gabuar, ransomware ose fshirjes aksidentale të skedarëve. Në këto momente, backup automatik për servera nuk është thjesht një kopje rezervë: është mekanizmi që përcakton sa shpejt një organizatë rikthehet në punë dhe sa të dhëna mund të humbasë.
Për një administrator sistemi ose një kandidat që po ndërton profilin e tij në Windows Server apo Linux Server, backup-i duhet parë si pjesë e arkitekturës së shërbimit. Nuk mjafton të instalosh një sistem operativ, të krijosh përdorues dhe të publikosh një aplikacion. Duhet të përcaktosh çfarë ruhet, ku ruhet, sa shpesh ruhet dhe si verifikohet rikthimi.
Çfarë mbulon backup automatik për servera
Backup automatik është procesi i krijimit të kopjeve të të dhënave, konfigurimeve ose të gjithë sistemit sipas një orari dhe politike të paracaktuar. Automatizimi heq varësinë nga veprimi manual i administratorit, i cili mund të harrojë një kopje, të përdorë një disk të gabuar ose të mos kontrollojë rezultatin e procesit.
Në praktikë, nuk ekziston një backup i vetëm që zgjidh çdo problem. Një server mund të ketë të dhëna të përdoruesve, databaza, makina virtuale, konfigurime të Active Directory, konfigurime rrjeti, certifikata dhe log-e. Vlera e secilit komponent është e ndryshme. Fshirja e një dokumenti mund të kërkojë rikthimin e një skedari, ndërsa dështimi i një domain controller kërkon rikthimin e kontrolluar të shërbimeve të identitetit.
Kjo është arsyeja pse politika e backup-it duhet të fillojë nga shërbimi që serveri ofron. Një file server kërkon versionim të skedarëve dhe ruajtje të të drejtave të aksesit. Një server databaze kërkon kopje të qëndrueshme të databazës dhe, sipas rastit, ruajtje të transaction logs. Një host virtualizimi kërkon mbrojtje për makinat virtuale, por edhe dokumentim të konfigurimit të hostit.
Dy objektiva që vendosin ritmin e backup-it
Para se të zgjedhësh një mjet, përcakto RPO dhe RTO. Këto dy terma përdoren shpesh në intervista teknike sepse tregojnë nëse kandidati e kupton vazhdimësinë e shërbimit, jo vetëm instalimin e tij.
RPO, ose Recovery Point Objective, tregon sasinë maksimale të të dhënave që organizata pranon të humbasë. Nëse backup-i kryhet çdo 24 orë, humbja e mundshme mund të arrijë deri në një ditë pune. Për një server me dokumente që ndryshojnë rrallë, kjo mund të jetë e pranueshme. Për një databazë me transaksione të vazhdueshme, zakonisht nuk është.
RTO, ose Recovery Time Objective, tregon kohën maksimale të pranueshme për rikthimin e shërbimit. Rikthimi i një serveri të plotë nga një kopje e madhe mund të marrë disa orë. Rikthimi i një skedari të vetëm mund të zgjasë pak minuta. Prandaj, frekuenca e backup-it nuk duhet ngatërruar me shpejtësinë e rikthimit.
Një politikë e mirë mund të përcaktojë, për shembull, backup ditor për skedarët, kopje më të shpeshta për databazat dhe backup javor ose mujor për arkivim afatgjatë. Zgjedhja varet nga vëllimi i të dhënave, buxheti, lidhja e internetit dhe kostoja reale e ndërprerjes së shërbimit.
Zgjidhja 3-2-1 dhe pse është ende relevante
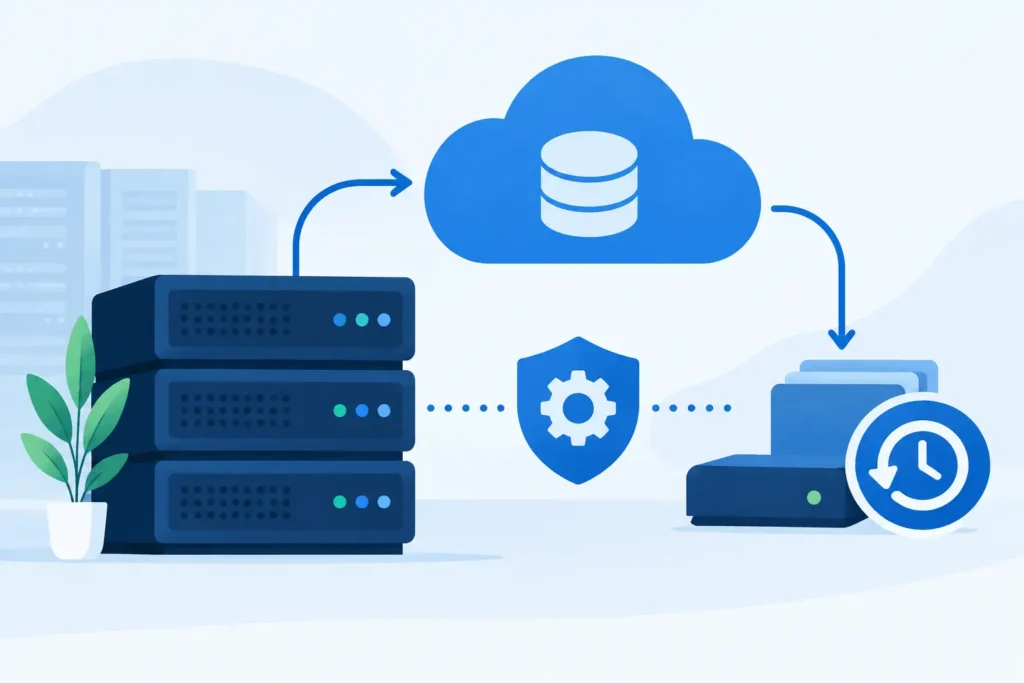
Një rregull praktik i përdorur gjerësisht është 3-2-1: mbaj të paktën tri kopje të të dhënave, në dy lloje të ndryshme ruajtjeje, me një kopje jashtë mjedisit kryesor. Kopja që ndodhet në të njëjtin server nuk konsiderohet mbrojtje reale. Nëse disku, sistemi operativ ose llogaria administrative komprometohet, mund të humbasin njëkohësisht prodhimi dhe backup-i.
Një skemë fillestare mund të përfshijë të dhënat aktive në server, një kopje lokale në NAS ose storage të dedikuar dhe një kopje të enkriptuar në një lokacion tjetër. Kopja lokale ndihmon për rikthim të shpejtë. Kopja jashtë lokacionit mbron nga dëmtimi fizik, vjedhja, zjarri ose sulmet që përhapen në rrjet.
Megjithatë, ruajtja në cloud nuk është automatikisht e sigurt vetëm sepse ndodhet jashtë zyrës. Duhet të kontrollohen enkriptimi, menaxhimi i kredencialeve, versionimi, politikat e fshirjes dhe kostoja e rikthimit të sasive të mëdha të të dhënave. Në një incident, një backup që nuk mund të shkarkohet brenda RTO-së së kërkuar ka vlerë të kufizuar.
Si ndërtohet një politikë backup-i në praktikë
Hapi i parë është inventarizimi. Identifiko serverët, rolet e tyre, pronarët e shërbimeve dhe të dhënat kritike. Mos supozo se gjithçka që ndodhet në disk duhet të ruhet me të njëjtin prioritet. Skedarët e përkohshëm, cache dhe instaluesit mund të rrisin madhësinë e backup-it pa sjellë vlerë në rikthim.
Më pas, klasifiko ngarkesat e punës. File server, database server, domain controller, web server dhe server virtualizimi kanë kërkesa të ndryshme. Për databazat, përdor backup që respekton konsistencën e aplikacionit. Për mjediset Windows, shërbime si VSS ndihmojnë që kopja të mos merret në një gjendje të paplotë gjatë shkrimit të të dhënave. Në Linux, procesi mund të kërkojë snapshot të volumit, dump të databazës ose ndalje të kontrolluar të një shërbimi, sipas aplikacionit.
Pastaj përcakto orarin. Backup-et e plota japin një bazë të qartë për rikthim, por konsumojnë më shumë hapësirë dhe kohë. Backup-et inkrementale ruajnë vetëm ndryshimet që nga kopja e fundit dhe zakonisht janë më efikase. Backup-et diferenciale ruajnë ndryshimet që nga backup-i i fundit i plotë. Nuk ka një zgjedhje universale: inkrementalet reduktojnë volumin ditor, por mund ta bëjnë rikthimin më kompleks nëse kërkohen shumë pika në zinxhir.
Në fund, vendos periudhën e ruajtjes. Një kopje ditore për shtatë ditë, kopje javore për një muaj dhe kopje mujore për një vit është një shembull i arsyeshëm, jo një standard i detyrueshëm. Organizatat me kërkesa ligjore ose financiare mund të kenë nevojë për ruajtje më të gjatë.
Automatizimi nuk zëvendëson monitorimin
Gabimi më i rrezikshëm është të shohësh një detyrë të planifikuar dhe të supozosh se backup-i po funksionon. Një job mund të dështojë për mungesë hapësire, kredenciale të skaduara, gabim rrjeti, certifikatë të pavlefshme ose skedar të korruptuar. Nëse nuk ka njoftime dhe kontroll të rregullt, problemi zbulohet vetëm kur duhet bërë rikthimi.
Çdo proces backup-i duhet të prodhojë log-e të lexueshme dhe alarme për dështimet. Administratori duhet të kontrollojë jo vetëm statusin “successful”, por edhe madhësinë e kopjes, kohëzgjatjen dhe devijimet nga sjellja normale. Një backup që papritur zvogëlohet në mënyrë drastike mund të tregojë se një volum kritik është përjashtuar nga politika.
Siguria është po aq e rëndësishme. Përdor llogari shërbimi me privilegjet minimale të nevojshme, aktivizo enkriptimin gjatë transferimit dhe në ruajtje, dhe kufizo aksesin për fshirje të backup-eve. Për mbrojtje më të fortë ndaj ransomware, mbaj kopje immutable ose offline kur infrastruktura dhe buxheti e lejojnë. Qëllimi është që një sulmues me akses në server të mos mund të fshijë edhe provat e rikthimit.
Testi i rikthimit është prova reale
Një backup pa test rikthimi është vetëm një supozim. Testimi duhet të përfshijë skenarë të ndryshëm: rikthim të një skedari, rikthim të një folderi me të drejtat e tij, rikthim të një databaze dhe, kur është e nevojshme, rikthim të një serveri ose makine virtuale në një mjedis të izoluar.
Gjatë testit, dokumento kohën e nevojshme, hapat e kryer dhe problemet e hasura. Verifiko që aplikacioni hap të dhënat, përdoruesit marrin aksesin e duhur dhe shërbimet nisen siç pritet. Kjo dokumentim kthehet në procedurë incidenti dhe redukton vendimmarrjet e improvizuara nën presion.
Në laboratorët e Windows Server dhe Linux Server, ky proces vlen të praktikohet si skenar pune: krijo të dhëna, planifiko backup-in, simulo fshirjen ose dështimin dhe kryej rikthimin. Njohuria teknike bëhet e besueshme kur kandidati mund të shpjegojë jo vetëm si konfigurohet një job, por edhe si provohet që ai rikthen shërbimin.
Një server i mbrojtur mirë nuk është ai që ka më shumë kopje, por ai për të cilin ekipi di saktësisht çfarë mund të rikthejë, në çfarë kohe dhe me cilat hapa. Filloni me një politikë të dokumentuar, testojeni në laborator dhe përmirësojeni sa herë që ndryshon infrastruktura.